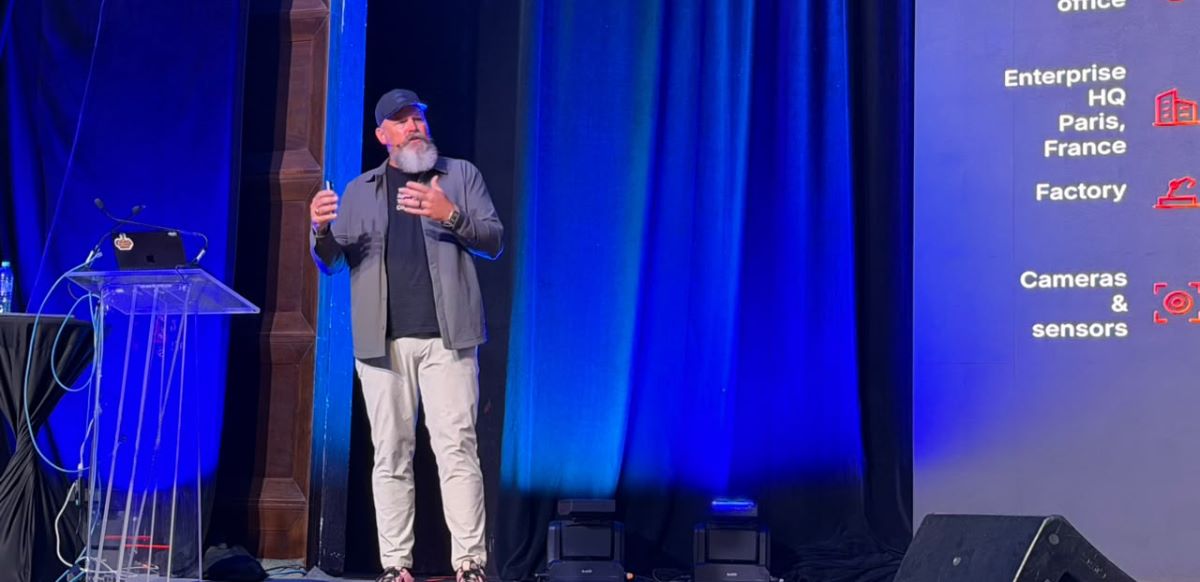
La próxima evolución de las operaciones de IT no consiste solamente en resolver incidentes con mayor velocidad, sino en anticiparlos antes de que afecten a los usuarios. Esa fue una de las ideas centrales de la presentación de Cory Minton, Global Field CTO de Splunk, durante Cisco Connect Latam, donde mostró la visión de la compañía para lo que denomina Agentic Operations.
La pregunta que utilizó para abrir la presentación resume el cambio de paradigma: “¿Qué pasaría si la caída nunca hubiera ocurrido?”
El planteo no es menor. Según las cifras presentadas durante la sesión, el downtime ya dejó de ser exclusivamente un problema técnico para convertirse en un asunto que puede llegar directamente al directorio. Minton mostró estimaciones según las cuales las grandes compañías pueden perder millones de dólares por interrupciones de sus sistemas, con impactos que se extienden desde la operación hasta la reputación y el valor de mercado.
Al mismo tiempo, resolver estos incidentes se vuelve cada vez más complejo.
Infraestructuras cada vez más difíciles de observar
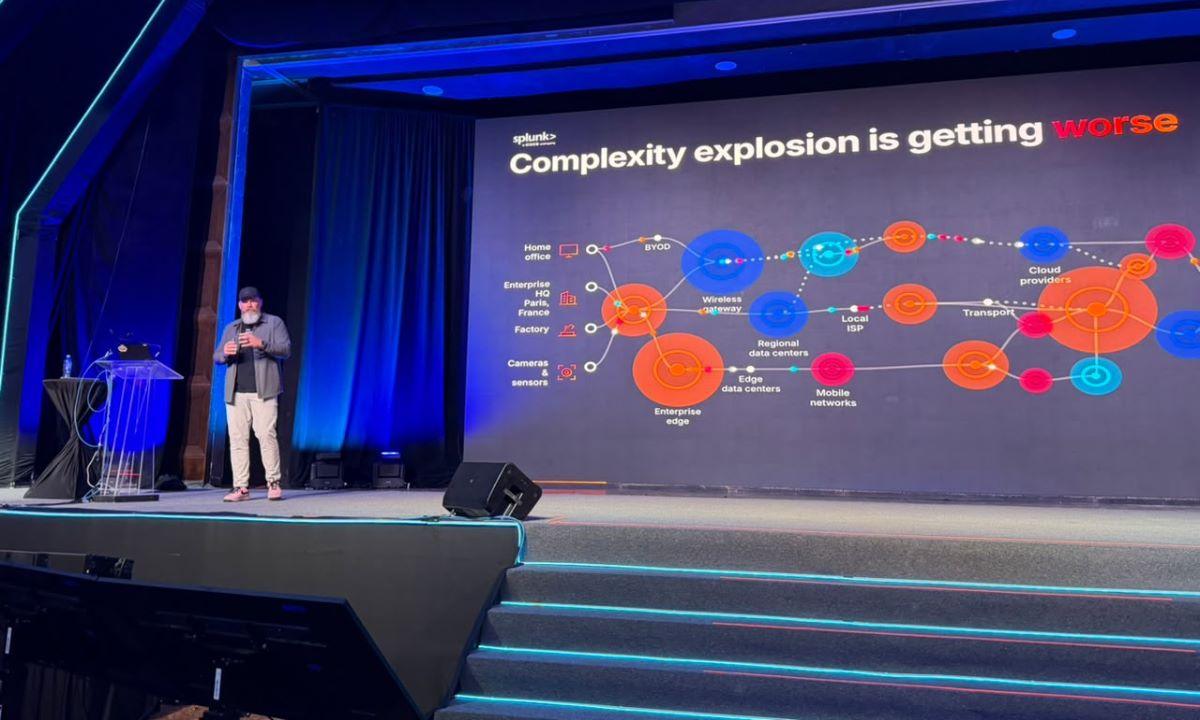
Las organizaciones operan actualmente sobre arquitecturas distribuidas que combinan datacenters, múltiples proveedores de nube, aplicaciones SaaS, redes móviles, dispositivos, sensores, oficinas remotas y servicios externos.
Para Splunk, esa “explosión de complejidad” hace que los modelos tradicionales de monitoreo reactivo resulten insuficientes.
La respuesta que propone la compañía parte de algo que, paradójicamente, no es nuevo: los datos.
Minton destacó la necesidad de contar con una fuente confiable de telemetría que reúna métricas, eventos, logs y trazas provenientes de diferentes puntos de la infraestructura. Esa información alimenta el Splunk Machine Data Lake y otros componentes de la plataforma, permitiendo que los modelos de inteligencia artificial trabajen sobre datos operativos contextualizados.
En otras palabras, antes de incorporar agentes, la organización necesita ordenar su información.
Predecir la falla antes de que ocurra
El siguiente paso consiste en utilizar modelos predictivos capaces de analizar grandes volúmenes de señales en tiempo real.
En la demostración se destacó que Splunk combinó su AI Toolkit con modelos de Cisco, entre ellos Cisco Deep Time Series Model, para analizar alrededor de 100.000 métricas en tiempo real.
El objetivo es establecer cuál debería ser el comportamiento esperado de cada métrica y detectar desviaciones antes de que alcancen niveles críticos.
Cuando una señal supera determinado umbral de confianza, el sistema puede generar una alerta por lo que Splunk denomina una desviación prevista respecto del comportamiento normal.
La diferencia respecto del monitoreo tradicional es significativa. La alerta no aparece necesariamente porque algo ya falló, sino porque el sistema identifica indicios de que podría hacerlo.
El agente investiga, la persona decide
Pero la predicción es solamente una parte del modelo.
Una vez detectada una anomalía, entran en escena los agentes de IA.
Según explicó Minton, estos agentes pueden correlacionar automáticamente la telemetría disponible, formular hipótesis sobre las posibles causas del problema y ordenarlas en función de la evidencia encontrada.
También pueden generar un plan de remediación paso a paso.
Sin embargo, la visión presentada por Splunk no supone eliminar a los equipos humanos del proceso. Una de las frases más claras de la presentación fue: “Los agentes investigan. Los humanos deciden”.
El profesional de SRE o del SOC puede revisar el razonamiento del agente y aprobar, modificar o rechazar la acción recomendada antes de que se produzcan cambios en los sistemas.
Splunk también destacó la importancia de que estas operaciones sean explicables y auditables. Cada acción realizada por un agente debería quedar registrada, incluyendo su identidad y el razonamiento utilizado para llegar a determinada recomendación.

Una empresa que pueda “curarse” antes de fallar
Splunk define este escenario como una empresa que se puede “curar” a sí misma, una organización capaz de utilizar telemetría, modelos predictivos y agentes para detectar problemas, investigarlos y eventualmente prevenirlos.
El proceso comienza con datos confiables, continúa con modelos que anticipan desviaciones y suma agentes capaces de investigar automáticamente el origen de los incidentes. La decisión final permanece, al menos en el modelo presentado, en manos humanas.
Cisco AI Canvas aparece aquí como espacio de colaboración, permitiendo que agentes, especialistas de SRE, SecOps, NetOps e ITOps trabajen sobre una misma investigación y accedan tanto a resúmenes generados por IA como a los datos subyacentes.
Para Splunk, esta transformación también redefine el concepto de observabilidad. En la era agéntica ya no alcanza con observar servidores, aplicaciones y redes: también será necesario observar y gobernar a los propios agentes.
La compañía plantea tres pilares para esa nueva etapa: observar y gobernar mediante Agent Observability, conectar agentes con telemetría confiable y permitir que actúen con contexto mediante herramientas y conexiones MCP.
El mensaje final de Minton fue concreto: las organizaciones no deberían esperar a tener operaciones completamente autónomas para empezar. Primero deben construir la base de datos, observabilidad y gobierno que permitirá que esos agentes puedan tomar cada vez más responsabilidades sin convertir la automatización en una nueva fuente de riesgo.
En esa visión, la próxima gran mejora de las operaciones de IT podría no medirse solamente por cuánto demora una empresa en recuperarse de una caída, sino por cuántas caídas logra evitar antes de que alguien llegue a percibirlas.