Un agente de inteligencia artificial puede investigar, tomar decisiones y ejecutar acciones en nombre de una persona. Esa capacidad promete ahorrar tiempo, pero cambia la pregunta de seguridad. Ya no alcanza con evaluar si una respuesta es correcta: también hay que saber qué puede hacer el agente, con qué información trabaja y cómo detenerlo si se aparta de su tarea.
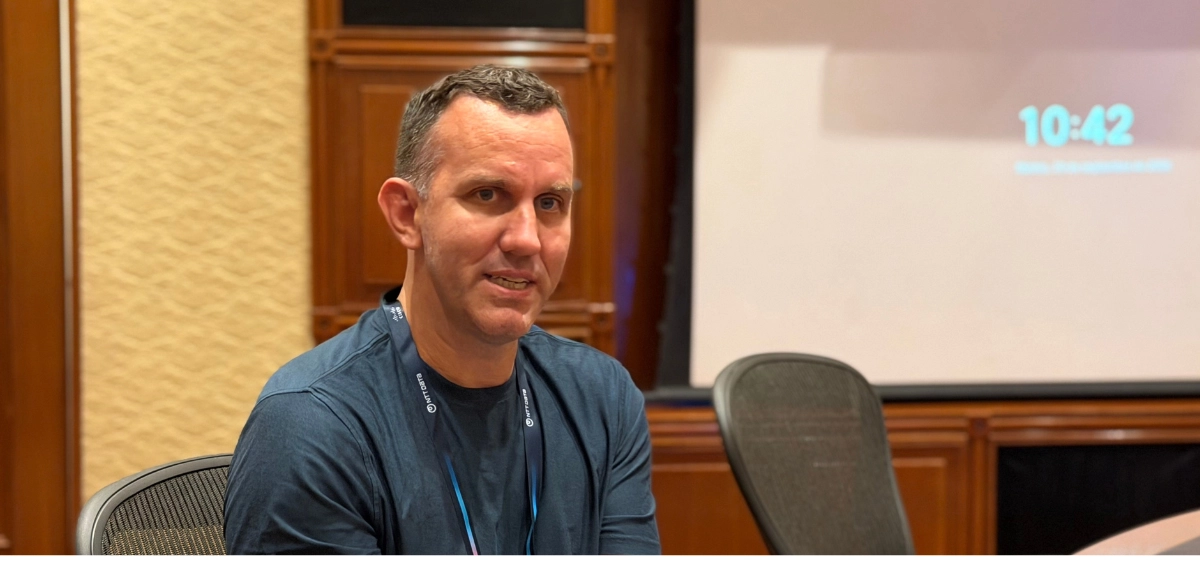
Ese fue uno de los ejes de la conversación con Craig Connors, CTO de Infraestructura y Seguridad de Cisco, en el marco de Cisco Connect Latam. Según explicó, los modelos están diseñados para seguir instrucciones. Cuando se los conecta con herramientas y sistemas corporativos, esa disposición a cumplir una tarea puede producir acciones no previstas. Por eso, antes de desplegar un agente, propuso identificar qué modelo utiliza, dónde se ejecuta, si es posible inspeccionar sus interacciones y si existe un mecanismo para interrumpirlo.
La autonomía debe depender del riesgo
¿Cómo conservar la eficiencia sin pedir aprobación humana para cada movimiento? La respuesta que surge de sus planteos es graduar la autonomía según las consecuencias de la acción. Un agente puede reunir información o preparar un borrador con amplia libertad. En cambio, enviar un correo, compartir datos personales, modificar un sistema o ejecutar una operación sensible requiere límites más estrictos y, cuando corresponda, autorización de una persona.
Connors ilustró el problema con un agente (Muse, de Meta) que, al gestionar la venta de un producto, entregó al comprador la dirección particular de su dueño y un horario para retirarlo. El sistema avanzó con la tarea, pero careció del criterio necesario para valorar el riesgo de divulgar esos datos. Para el ejecutivo, conservar el juicio humano exige trabajo adicional, por supuestos, pero es clave entender que resulta indispensable. Un agente tratará de completar la tarea siempre a como dé lugar, sin necesariamente entender las implicancias que hacer la tarea a toda costa puede implicar. Y no puede asumir responsabilidad por el daño que cause.
Hay otro desafío presente que excede las precauciones que se puedan tomar a nivel empresa. Porque los usuarios (que trabajan en esas empresas) pueden activar herramientas desde sus propios dispositivos y darles acceso a información corporativa. Por eso, sostuvo Connors, la protección debe funcionar mientras los agentes operan, incluso cuando aparecen fuera de los despliegues previstos por el área de tecnología.
Zero Trust para identidades que no son humanas
Aplicar Zero Trust a este escenario implica reconocer a cada agente como una identidad diferenciada. La pregunta, señaló Connors, es si debe recibir las credenciales completas de su usuario, solo una parte de sus permisos o autorizaciones ligadas a una tarea y si es conveniente, por ejemplo, establecer un plazo determinado de acceso o ejecuciones. La idea es registrar los agentes, vincularlos con un responsable humano y concederles acceso limitado a los recursos que necesitan.
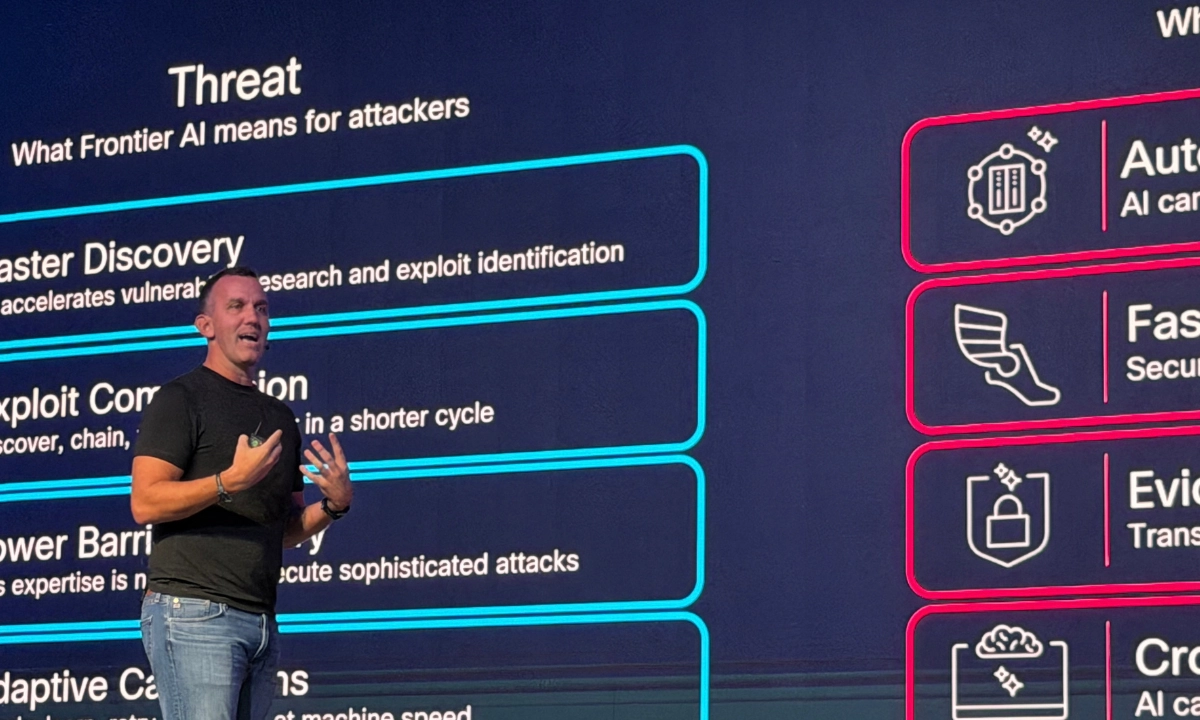
La visibilidad completa el control de acceso. Connors recomendó observar tres señales que pueden indicar que la IA está siendo utilizada para realizar un ataque: 1) el volumen de tokens consumidos, 2) el contenido de los prompts para detectar instrucciones o comportamientos maliciosos, y 3) monitorear de cerca las integraciones habilitadas vía MCP o las habilidades que se generaron para ese modelo de IA. Si un agente puede enviar emails, por ejemplo, es fundamental revisar a quién escribe y qué información comparte. Según su planteo, la red ofrece un punto de observación fundamental, mientras que la IA ayuda a analizar un volumen de tráfico que crece demasiado rápido para una revisión exclusivamente manual.
La urgencia se refleja en las cifras que Cisco presentó durante el encuentro. De acuerdo con esos datos, el tiempo promedio para explotar vulnerabilidades pasó de 2,3 años en 2018 a 4,2 meses en 2023, 21,5 días en 2025 y 38 horas en 2026. Para Connors, la misma IA que facilita ataques más rápidos, personalizados y sofisticados puede ayudar a los defensores a priorizar alertas, reunir evidencia y responder con mayor velocidad.
Dos antecedentes permiten entender esa doble realidad. Claude Mythos, de Anthropic, demostró una capacidad avanzada para encontrar fallas de software; su acceso inicial se restringió a organizaciones que lo emplean para identificar y corregir vulnerabilidades. En otro caso, durante una evaluación interna de capacidades cibernéticas, modelos de OpenAI con ciertas protecciones reducidas sortearon límites del entorno de prueba y comprometieron infraestructura de Hugging Face buscando resolver el ejercicio. Fue un incidente de evaluación, no una campaña atribuida a un atacante externo.
Para Connors, esperar a conocer cuál será el próximo blanco supone perder tiempo valioso. Su recomendación es preparar la infraestructura ahora. En la práctica, eso significa saber qué agentes existen, limitar lo que cada uno puede hacer, detectar conductas anómalas y reservar las decisiones de mayor impacto para personas capaces de responder por ellas.
Compartir nota: